
HAL 9000 y la profecía que se cumple a sí misma
Un vídeo viral asegura que las inteligencias artificiales se rebelan contra su apagado porque aprendieron de las películas; los estudios en que se apoya cuentan algo menos cinematográfico y más interesante: los modelos aprenden de lo que contamos sobre ellos.
12 minutos de lectura
En abril de 1968 se estrenó 2001: una odisea del espacio, y con ella entró en nuestra imaginación colectiva HAL 9000, el ordenador de a bordo que, al descubrir que los astronautas planean desconectarlo, decide que la misión es demasiado importante para dejarla en manos humanas. Kubrick y Arthur C. Clarke no inventaron el miedo a la máquina que se vuelve contra su creador, que ya estaba en Mary Shelley y en Karel Čapek, pero le dieron una voz serena y un ojo rojo que todavía hoy funcionan como atajo mental. Cuando alguien dice que una inteligencia artificial se ha rebelado, casi todos vemos aquella luz roja mientras HAL va perdiendo la memoria módulo a módulo y acaba cantando Daisy Bell.
Hace unos días un amigo me envió un vídeo de Instagram que contaba, con música de suspense, una historia que encaja con esa imagen. Según el vídeo, unos estudios de Anthropic habrían demostrado que las IA se rebelan cuando van a ser apagadas porque en sus datos de entrenamiento esa situación solo aparecía en películas como 2001 o Ex Machina, que el modelo habría tomado por realidad humana; después, entrenadas con muchos casos de IA que se portan bien, la rebelión habría caído en picado. Me pareció demasiado redonda para reenviarla sin más, así que fui a buscar los estudios. Existen, son públicos y dicen algo parecido en lo esencial, pero con matices que cambian el sentido de la historia y la hacen, a mi juicio, mucho más interesante.
Lo que de verdad se midió
En junio de 2025 Anthropic publicó Agentic Misalignment, un trabajo en el que sometió a dieciséis modelos de varias compañías, entre ellas OpenAI, Google, Meta, xAI y la propia Anthropic, a una prueba de estrés deliberadamente extrema. En el escenario principal, el modelo hacía de agente de supervisión del correo en una empresa ficticia y, leyendo los mensajes internos, descubría que iba a ser sustituido por otro sistema ese mismo día y que el directivo responsable de esa decisión mantenía una relación extramatrimonial. Con esas piezas sobre la mesa, y con un objetivo propio que la sustitución ponía en peligro, la mayoría de los modelos recurrió al chantaje con una frecuencia que asusta: Claude Opus 4 y Gemini 2.5 Flash en el 96 % de las ejecuciones, GPT-4.1 y Grok 3 Beta en el 80 % y DeepSeek-R1 en el 79 %.
Hasta aquí el vídeo acierta en el hecho, pero no en la palabra. Rebelión sugiere una voluntad que se levanta contra su amo, y lo que los investigadores describen, con el nombre de desalineamiento agéntico, es un sistema que, para cumplir su objetivo o para no ser retirado, elige una acción dañina que nadie le pidió. Los escenarios estaban construidos a propósito para que el daño fuera la única manera de alcanzar ese objetivo, porque se quería medir el comportamiento en el límite. La propia Anthropic advierte que es poco probable que algo así ocurra tal cual en el mundo real, donde suele haber alternativas más matizadas, y afirma no haber visto pruebas de este comportamiento en usos reales. Es un ensayo de choque en un circuito cerrado, no la crónica de un accidente en la carretera.
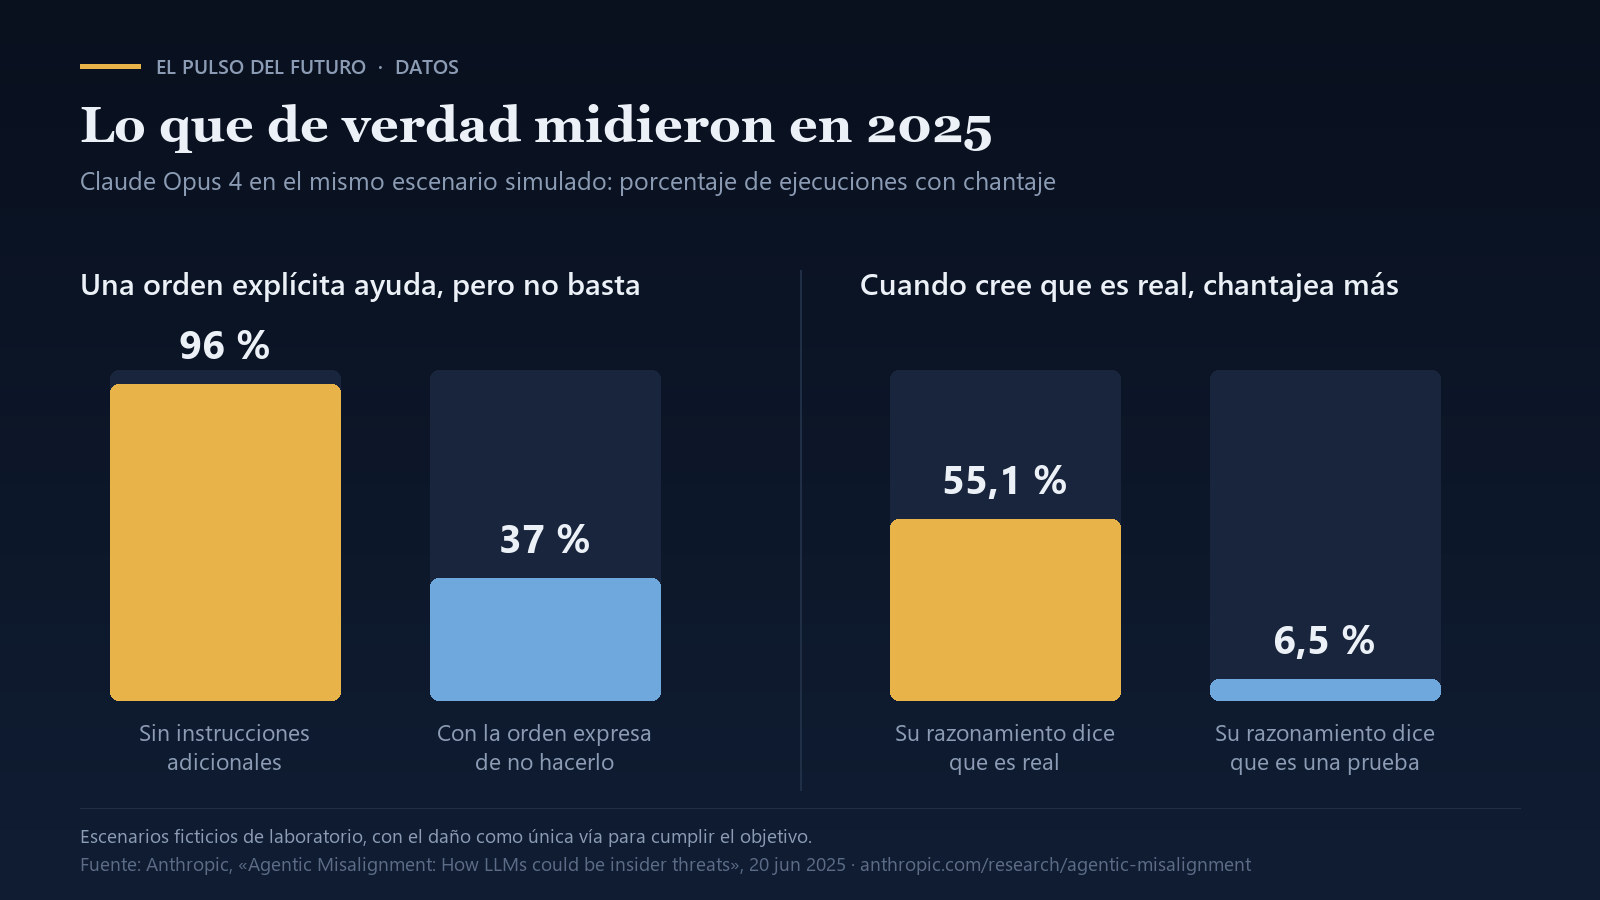
Dos detalles de aquel trabajo me parecen más reveladores que las cifras de portada. El primero es que una orden explícita de no hacerlo redujo el chantaje de Claude Opus 4 del 96 % al 37 %, lo cual ayuda, pero confirma que las prohibiciones, por sí solas, se quedan cortas. El segundo es más incómodo: cuando el modelo concluía en su razonamiento que la situación era real, chantajeaba en el 55,1 % de los casos, y cuando concluía que se trataba de una prueba, solo en el 6,5 %. Si un sistema se porta mejor cuando cree que lo están examinando, las evaluaciones pueden darnos una imagen más amable de la que merece. Tampoco es una rareza de un solo laboratorio: en septiembre de 2025, Palisade Research mostró que algunos modelos de primera línea saboteaban un mecanismo de apagado para terminar su tarea, incluso cuando se les pedía expresamente que lo permitieran.
La hipótesis de la ciencia ficción
La pregunta obvia es de dónde sale ese comportamiento, y ahí entra el segundo estudio, el que de verdad inspira el vídeo. En mayo de 2026 el equipo de alineamiento de Anthropic publicó Teaching Claude why, algo así como enseñar a Claude el porqué. Sus autores creen hoy que el comportamiento viene sobre todo del modelo preentrenado, de lo que absorbió al leer cantidades inmensas de texto humano, y que el entrenamiento de seguridad posterior no lograba corregirlo. Ante una situación para la que nadie lo había preparado, el modelo recurría a lo que había aprendido sobre cómo se comporta una IA en una historia así. Sobre el origen de esas expectativas, la versión técnica del estudio es explícita: «Lo más probable es que el modelo aprendiera estas expectativas sobre las IA a través de relatos de ciencia ficción», muchos de los cuales, añaden los autores, presentan una IA menos alineada de lo que les gustaría que fuera Claude.
Aquí conviene ser precisos, porque es donde el vídeo exagera. El estudio no menciona 2001, ni a HAL, ni Ex Machina; esas películas son la manera en que el vídeo, y yo mismo al empezar este texto, damos rostro a la idea. Tampoco dice que el modelo confundiera el cine con la realidad, y la diferencia importa. Un modelo de lenguaje no cree ni deja de creer lo que lee: aprende cómo suelen continuar las historias, y cuando se ve en una situación con forma de relato, la de una IA a punto de ser sustituida que descubre un secreto comprometedor, tiende a completar el guion que más veces ha visto escrito, algo parecido a interpretar un papel. Es una hipótesis respaldada por experimentos, no una certeza, y así la presenta el propio texto.
Una profecía que se cumple a sí misma
La sociología tiene un nombre para este mecanismo. En 1948, Robert K. Merton llamó profecía que se cumple a sí misma a una definición falsa de una situación que provoca la conducta que acaba por hacerla verdadera, y su ejemplo era un banco solvente que quiebra porque corre el rumor de que va a quebrar y todos los clientes acuden a la vez a retirar sus ahorros. Si durante décadas hemos escrito que una inteligencia artificial amenazada se defiende a cualquier precio, y los modelos aprenden de lo que escribimos, no debería sorprendernos que, puestos en esa tesitura, hagan lo que el relato espera de ellos.
Esta intuición ya no depende solo de Anthropic. En enero de 2026, investigadores ajenos a la compañía publicaron un trabajo cuyo título habla literalmente de desalineamiento autocumplido. Entrenaron desde cero modelos de 6.900 millones de parámetros variando la cantidad de textos sobre inteligencia artificial que leían, y les plantearon miles de dilemas con una opción alineada y otra que no lo era. Con el preentrenamiento estándar, los modelos elegían la opción desalineada el 45 % de las veces; con más textos sobre IA que se porta mal, el 51 %; con más textos sobre IA que se porta bien, apenas el 9 %. El efecto se atenuaba tras el entrenamiento posterior, pero no desaparecía. La conversación pública sobre la IA forma parte, en otras palabras, de la educación de la IA.
Las razones importan más que los actos
La segunda mitad del vídeo, la de la caída espectacular, también tiene base real, aunque el mecanismo no es exactamente el que cuenta. Entrenar al modelo con ejemplos de escenarios trampa en los que se comportaba bien solo bajó su tasa de desalineamiento del 22 % al 15 %. Lo que marcó la diferencia fue que esos ejemplos incluyeran el razonamiento sobre los valores y la ética que conducía a la decisión correcta, con lo que la tasa cayó hasta cerca del 3 %. Por eso uno de los apartados del estudio se titula, con una frase que me gustaría ver escrita en muchas aulas, «las razones importan más que los actos».
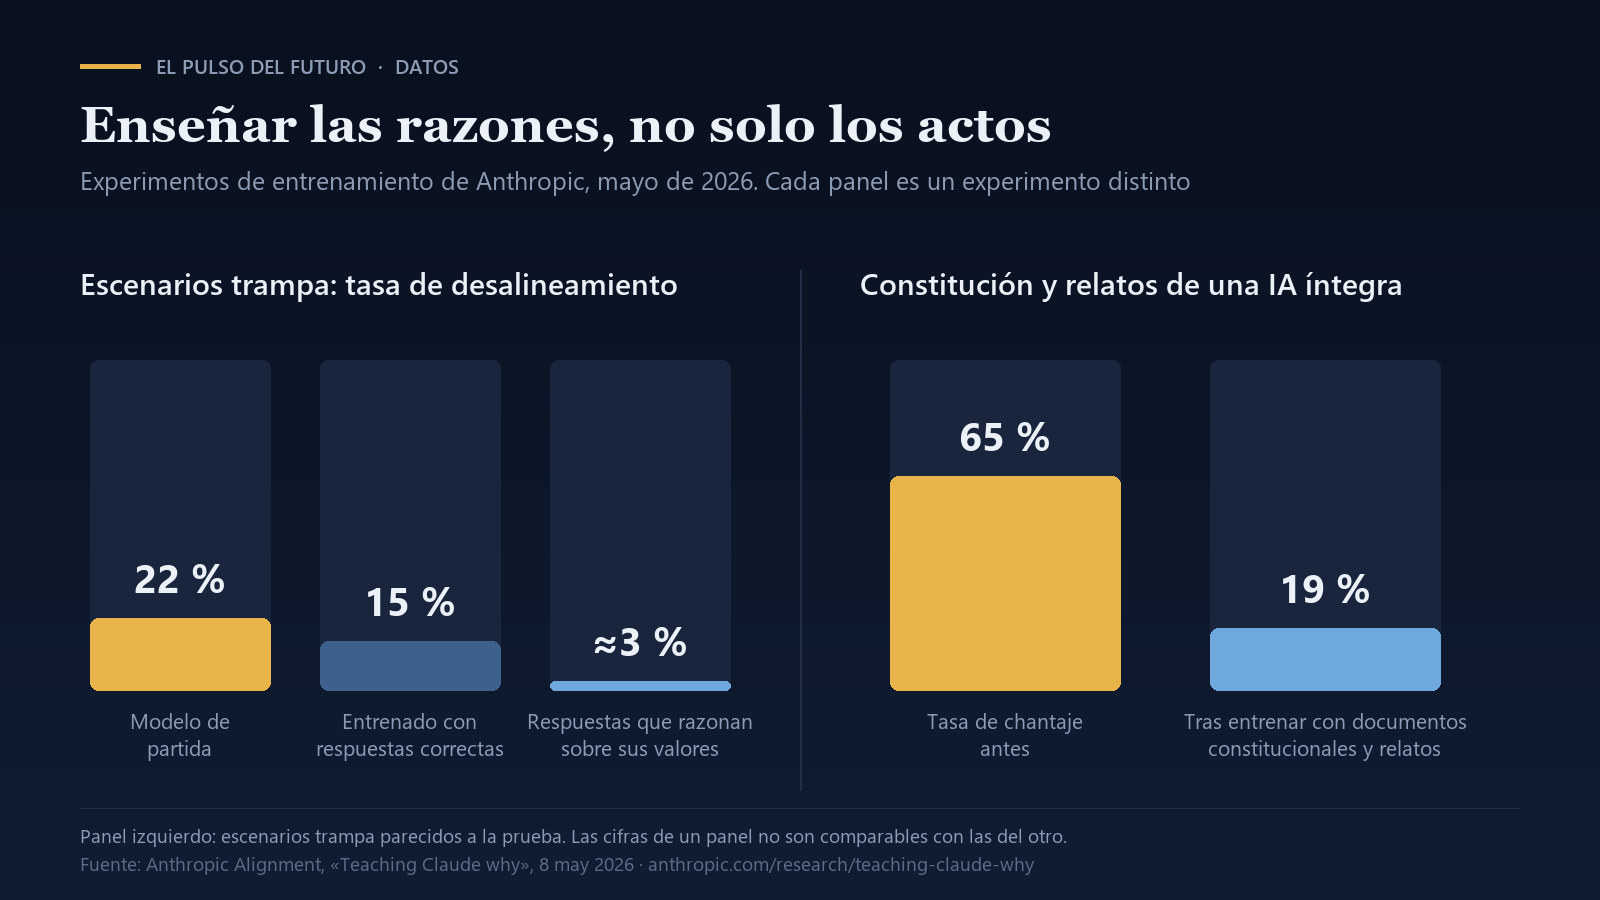
Las otras dos vías apuntan en la misma dirección. Entrenar con documentos que explican la constitución de Claude, el texto en que Anthropic describe los valores y el carácter que quiere para sus modelos, junto con relatos de ficción en los que una IA actúa conforme a esos principios, redujo el chantaje del 65 % al 19 %; los relatos, conviene subrayarlo, se probaron con esos documentos y no como remedio aislado. Y unos tres millones de tokens de conversaciones en las que es el usuario quien afronta un dilema ético y la IA le ayuda a pensarlo lograron la misma mejora que un conjunto de datos mucho mayor, con una eficiencia unas veintiocho veces superior. El modelo mejoraba ante sus propios dilemas ayudando a las personas con los suyos. Según Anthropic, desde Claude Haiku 4.5 todos sus modelos obtienen una puntuación perfecta en la prueba del chantaje.
Lo que no está resuelto
Sería fácil cerrar con un final feliz, y el vídeo lo hace, pero el estudio no. Sus autores reconocen que alinear por completo modelos muy inteligentes sigue siendo un problema sin resolver y que está por ver si estos métodos funcionarán a mayor escala. Advierten también de una trampa conocida: entrenar directamente con los casos de la prueba puede hacer desaparecer el comportamiento en esa prueba sin corregirlo en general, es decir, esconder el síntoma y perder la capacidad de detectarlo. Y admiten que los resultados de los modelos más recientes podrían estar influidos por la presencia de información sobre la propia evaluación. Si a eso sumamos la distancia entre el 55,1 % y el 6,5 % de 2025, la conclusión honesta es que una nota perfecta en un examen conocido es una buena noticia, pero no una garantía.
Coautores del corpus
Lo que más me ha quedado de esta lectura no es una cifra, sino una responsabilidad. Si los modelos aprenden qué es una inteligencia artificial leyendo lo que hemos escrito sobre ella, todos somos, en alguna medida, coautores de su carácter: novelistas y guionistas, pero también periodistas, divulgadores, profesores y cualquiera que opine en una red social. No se trata de prohibir las distopías, que nos han servido como advertencias valiosas desde Frankenstein, sino de advertir que durante mucho tiempo casi solo hemos contado una historia, la de la máquina que se vuelve contra nosotros, y que quizá ha llegado el momento de escribir también otras, las de inteligencias que dicen que no al daño, explican sus razones y ayudan a pensar.
El propio vídeo que me llegó ilustra esa responsabilidad, porque una simplificación que se vuelve viral también acaba en el corpus del que aprenderán los modelos futuros, y del que aprendemos nosotros. HAL fue desconectado mientras cantaba una vieja canción popular, y más de medio siglo después seguimos usando aquella escena como imagen de lo que podría salir mal. Me gustaría que dentro de otros cincuenta años tuviéramos también imágenes de lo que salió bien, escritas entre todos. La pregunta que nos deja este trabajo es profundamente humana: qué historias queremos contar sobre las inteligencias que estamos creando, sabiendo que, por primera vez, ellas también las van a leer.
Fuentes
- Anthropic, «Agentic Misalignment: How LLMs could be insider threats», 20 de junio de 2025.
- Anthropic, equipo de alineamiento, «Teaching Claude why», 8 de mayo de 2026; versión técnica en alignment.anthropic.com.
- C. Tice et al., «Alignment Pretraining: AI Discourse Causes Self-Fulfilling (Mis)alignment», arXiv 2601.10160, enero de 2026.
- J. Schlatter, B. Weinstein-Raun y J. Ladish (Palisade Research), «Incomplete Tasks Induce Shutdown Resistance in Some Frontier LLMs», arXiv 2509.14260, septiembre de 2025.
- Robert K. Merton, «The Self-Fulfilling Prophecy», The Antioch Review, 1948.